はじめに
3-shake 高杉です。
今回2026年10月20日に開催された「dbt World Tour 2026 東京」に参加してきました。
dbt World Tourとは、dbtの最新の動向やdbtを実際に業務に使っているユーザーの体験などを聞けるイベントになります。
面白い話が色々と聞けたので、今回は色々と振り返ってみようと思います。
2026年10月20日 dbt World Tour 東京 | dbt Labs
今回は主にdbt Labs社のセッションをメインで取り扱って、次回に各企業ごとのセッションでまとめてみようと思います。
dbt Labs社は主にdbtの新たな機能の紹介で、企業ごとのセッションはdbtとそれを取り巻く環境の話になるため分けて紹介しようと思います。
オープニングキーノート:Level Up
【発表者】
Alexis Jones
VP, Product Marketing
dbt Labs
Nina Anderson
Senior Manager, Partner Solutions Architecture
dbt Labs
最初のセッションはdbt LabsのVPであるAlexis JonesとSenior ManagerであるNina Andersonによる基調講演となります。
こちらの講演ではdbtとAIを取り巻く市場の変化と、その中でdbtはこれからどのように進化していくのかを紹介しました。
印象的だったのはこれからはエージェントがデータのコンシューマになるということ。
これからはエージェントがデータからインサイトを引き出して、ビジネス上の価値を生み出す時代になると述べていました。
今回のdbt World Tourのテーマは「Level Up」であり、その理由はデータを取り巻く環境が変わっていく中で、それに関わる人たちもレベルアップするということ、そしてdbtもレベルアップしていくということでした。
その後はdbtのv2やdbt StateとWizardなどdbtの機能についての紹介をしました。
dbt Open Adventure
【発表者】
Elias DeFaria
Director, Product Management
dbt Labs
Eliasさんの発表では実際にdbtのv2を動かしたデモを見せてくれました。
ここではdbtのv2がv1と比べて、どのように変わったのかをまずは紹介しました。
特に印象に残ったのはdbt testです。
unit testのデモでは一回目に行ったunit testでは1.22秒かかったのが、2回目に実行すると0.08秒で終了しました。
今回のデモではSnowflakeを使っている環境でのデモでしたが、dbt v2では一度目のテストをSnowflakeで行い、二度目ではローカル環境のDuckDBで行われるというものでした。
これはユニットテストの実行コストの削減とパフォーマンスの向上につながることが期待できそうですね。さらに、今回のセッションで注目したのはdbt StateとLake Computeでしょう。
AlexisさんとNinaさんのセッションでもあったのですが、今回のdbt World Tourでは特に注目したい新機能だと思いました。
以下にEliasさんの発表を元に、二つの機能の特徴を挙げてみます。
・dbt State
一度ビルドしたdbtプロジェクトに対して、もう一度ビルドする場合、上流のソースコードやモデルで定義の変更が無い場合、再度ビルドを行わずに、その前にビルドしたソースコードやモデルを再利用するというものです。
今までならビルドを実行するたびに全てのリソースを再ビルドしていたものが、今回は変更分だけをビルドすることでパフォーマンスとコスト削減が期待できます。
・Lake Compute
データウェアハウスでは大量のデータを処理するコストの高いクエリを毎日ビルドして実行するケースもあります。これまでのアプローチであればよりコストの安いデータウェアハウスへの移行やクエリのリファクタリングが考えられました。
ですが、これらは膨大な労力を必要とするものでした。
今回のデモではSnowflake上で構築されていたテーブルがIcebergテーブルとして再構築され、DuckDBで実行されたのちに、その結果をSnowflake上のIcebergカタログとして登録してSnowflake側からもそのデータを用いることができるようにするというものです。
dbt Stateで、runを最適化:コンピュートの削減、データの鮮度向上、そしてより速いiterationを実現
【発表者】
三角 勇貴
Partner Solutions Architect
dbt Labs
次のdbt Labs三角さんによるdbt Stateの詳細についての発表でした。
dbt StateはオープニングキーノートやEliasさんの発表でもありましたが、dbtを使った再ビルドでは変更分だけをビルドして、変更が無いものはスキップするというものでした。
他にも、例えば今までデータの更新を時間ごとや週ごとに行っていた場合はそれぞれの定義を行なって管理することができましたが、dbt Stateだとそれも集約できるというのが便利だなと思いました。
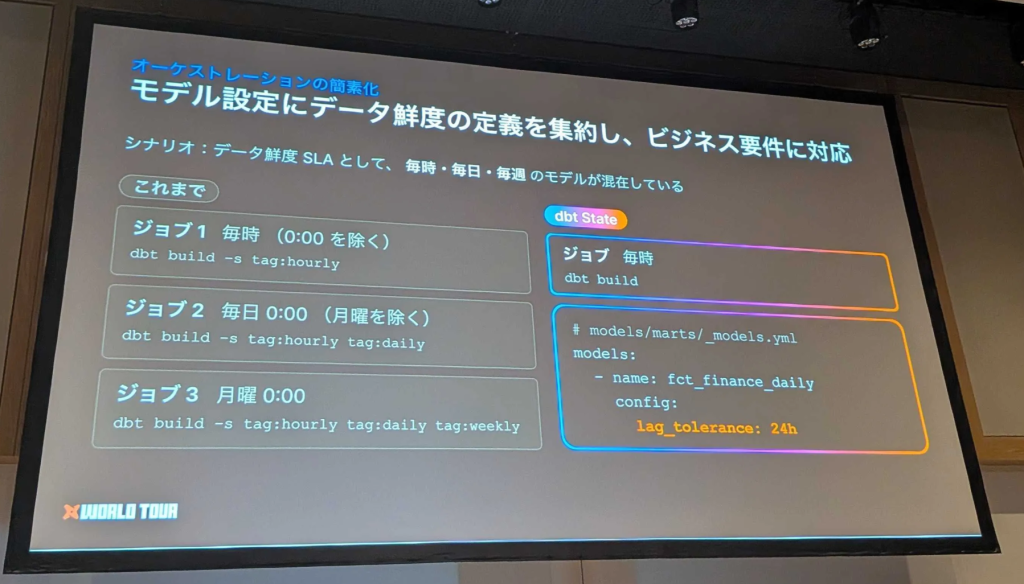
そして、もう一つdbt Stateのメリットとして印象に残ったのはエージェントのガードレールとしての機能も果たしてくれるということですね。
今までであれば、変更の有無に関わらず全て再ビルドしていたので、頻繁な更新をしていたらコストが高くなっていたのもdbt Stateを合わせて使うと変更分だけの更新だから安心して使うことが期待できそうだなと思いました。
今後の展望のお話では、SLAの設定や下流に影響する場合のみビルドするなど、さらに便利になりそうなお話も聞けていいなと思いました。
dbt Wizard:データ開発におけるAIチームメイト
【発表者】
伊藤 俊廷
Staff Solutions Architect
dbt Labs
次はdbt Labs伊藤さんによるdbt Wizardの発表でした。
実はdbt Wizardは一度触ったことがあるのですが、これはいわゆるプロンプトで指示を出せばモデルの作成からdbtの実行まで行ってくれるdbtに特化したエージェントです。
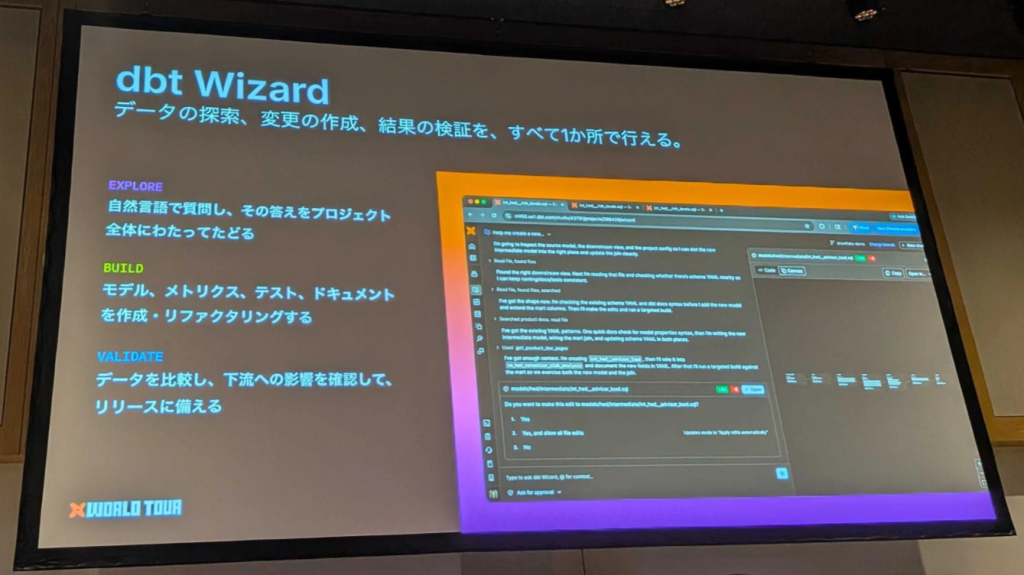
dbt Wizardは現在は3つのインターフェースがあるようです。
・dbt Wizard in platform (プレビュー版)
・dbt Wizard Desktop (パブリックベータ版)
・dbt Wizard CLI (パブリックベータ版)
今回のセッションではdbt Wizardの概要についての紹介とその後いくつかのシナリオを想定した場合におけるユースケースのデモも紹介いただきました。
dbt Wizardのデモを見ていて個人的に注目したのは、最初のタスクについてエージェントに作業させている時に、別のタスクの指示を出すと新規でチャットを作成して最初のタスクの邪魔にならないような挙動になっていることでした。
今となっては当たり前の挙動なのかもしれないですが、dbtの操作をエージェントにさせているという状況でこれができるのはなかなかに便利ではないでしょうか?
また、UIも一つの画面で網羅的に操作できる仕様なのは良かったですね。
実践オープン・データ・インフラストラクチャ:Apache Icebergとmeshでdbtプロジェクトの可能性を解き放つ
【発表者】
Lee Bond-Kennedy
Director, Solutions Architect
dbt Labs
dbt Labs社の最後の発表であるLeeさんによるセッションでは通常はdbtプロジェクトは一つのデータウェアハウスでしか動かせませんが、その問題をオープンテーブルフォーマット、dbt Catalog、Lake Computeを駆使して解消することについてお話しいただきました。(デモもありました)
個人的に注目したいのはまずはIcebergです。
オープンテーブルフォーマットとLake Computeの話はEliasさんのセッションでもありましたが、このセッションではIcebergのテーブルが複数のデータウェアハウス環境や、Lake Computeでどのように扱えるのかデモがありました。
ここで出てきたのがcatalogs.ymlというものです。
これはDatabricksのUnity CatalogやSnowflake Horizon CatalogやApache Polarisのようなカタログ対応を指定して、さらにアダプターとしてSnowflakeやDatabricks、BigQueryを指定して使用します。(ちなみにBigQueryでは実際はLakehouse(旧BigLake)になるようです)
今回のデモではSnowflakeとDatabricksを使ったデモで、それぞれのプラットフォームを横断的にデータを読み取り、処理ができるような構成になっていました。
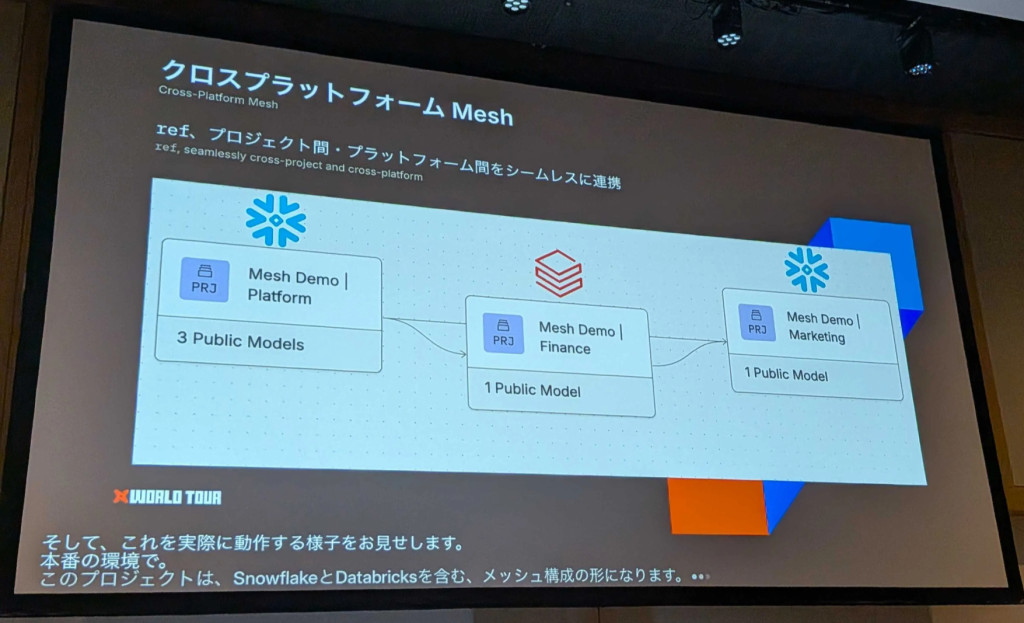
これらの異なるプラットフォーム間の参照はS3ストレージやGoogle Cloud Storageを介して行われているようですね。
そして、次にLake Computeのデモがありました。
Lake Computeはdbt LabsとFivetranによるマネージド・コンピューティングエンジンとのことでした。
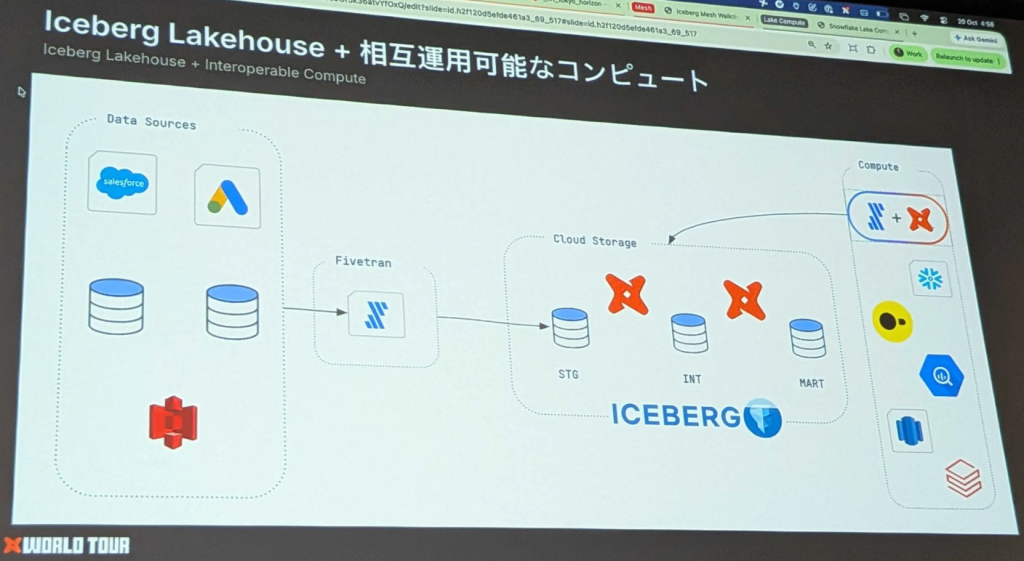
このデモでは、SnowflakeでIcebergフォーマットに変換してステージングレイヤーを作成し、次にLake ComputeがDuckDBを使って下流のテーブルを作成するデモでした。
そして、これはストレージとテーブルフォーマットは共有されている環境で実現されているものでした。
今回のデモを通じて、データの世界ではストレージとコンピューティングの分離に続いて、テーブルフォーマットの分離も起こりつつあることを紹介いただきました。
最後に
今回はdbt World Tourに参加して聞いたdbt Labs社のセッションを中心にまとめました。
発表内容を振り返ると、dbtの新機能とdbtをよりシームレスに使うためのAIサービスの紹介が
メインでしたがdbtは様々なデータプラットフォームをつなげる存在として今後ますます注目されると思います。
私も今はdbtのv1をメインに触っているのですが、今回の発表を機にv2も触ってみたいですね。
特にIcebergと組み合わせて様々なデータプラットフォームに活かせるのが素晴らしいですね。
今後も様々な形でdbtを業務に活かせればと思いました。
(私はIcebergもDuckDBも好きなのです笑)
今回は企業セッションも色々聞いたので、またまとめてみたいと思います。